September 11, 2025
Sessões do paper-club: LIMO: Menos é mais para raciocinar
O raciocínio da IA pode não depender de grandes conjuntos de dados: o LIMO revela que habilidades matemáticas complexas surgem com poucos ex

O campo da pesquisa de IA há muito tempo defende a suposição de que tarefas complexas de raciocínio exigem grandes quantidades de dados de treinamento para alcançar a competência. No jornal “LIMO: Menos é mais para raciocinar” [1], os pesquisadores Yixin Ye, Zhen Huang, Yang Xiao, Ethan Chern, Shijie Xia e Pengfei Liu da SJTU, SII e GAIR desafiam essa suposição fundamental com uma descoberta impressionante. Seu trabalho demonstra que capacidades sofisticadas de raciocínio matemático em grandes modelos de linguagem podem ser efetivamente extraídas com surpreendentemente poucos exemplos, invertendo a sabedoria convencional e sugerindo uma mudança de paradigma na forma como entendemos o surgimento de habilidades cognitivas complexas em sistemas de IA.
A abordagem atual para desenvolver capacidades de raciocínio em grandes modelos de linguagem normalmente envolve o ajuste fino supervisionado em grandes conjuntos de dados, geralmente excedendo 100.000 exemplos. Essa prática decorre de duas suposições generalizadas: primeiro, que dominar processos cognitivos complexos requer extensas demonstrações supervisionadas e, segundo, que o ajuste fino supervisionado leva principalmente à memorização e não à verdadeira generalização. Trabalhos anteriores mostraram algum sucesso com essa abordagem, mas com um custo computacional substancial e uma carga de coleta de dados. Enquanto isso, avanços recentes transformaram fundamentalmente a forma como os LLMs adquirem, organizam e utilizam o conhecimento de raciocínio, com modelos básicos modernos agora incorporando quantidades sem precedentes de conteúdo matemático durante o pré-treinamento e novas técnicas permitindo cadeias de raciocínio mais longas no momento da inferência.
O LIMO desafia o status quo ao demonstrar que, com apenas 817 amostras de treinamento cuidadosamente selecionadas, os modelos podem alcançar 57,1% de precisão no altamente desafiador benchmark AIME e 94,8% no MATH, superando dramaticamente os modelos anteriores baseados em SFT, que alcançaram apenas 6,5% no AIME e 59,2% no MATH usando 100 vezes mais dados de treinamento. Conforme ilustrado na Figura 1, isso representa um ganho de desempenho notável de 778% no AIME usando apenas 1% dos dados de treinamento. Os autores propõem a hipótese de raciocínio Menos é Mais, que postula que, quando o conhecimento do domínio é codificado de forma abrangente durante o pré-treinamento, capacidades sofisticadas de raciocínio podem surgir por meio de demonstrações mínimas, mas precisamente orquestradas, de processos cognitivos. A principal inovação não está no dimensionamento de dados, mas na qualidade das cadeias de raciocínio que tornam o processo cognitivo explícito e rastreável, funcionando como “modelos cognitivos” que mostram ao modelo como utilizar efetivamente sua base de conhecimento existente.
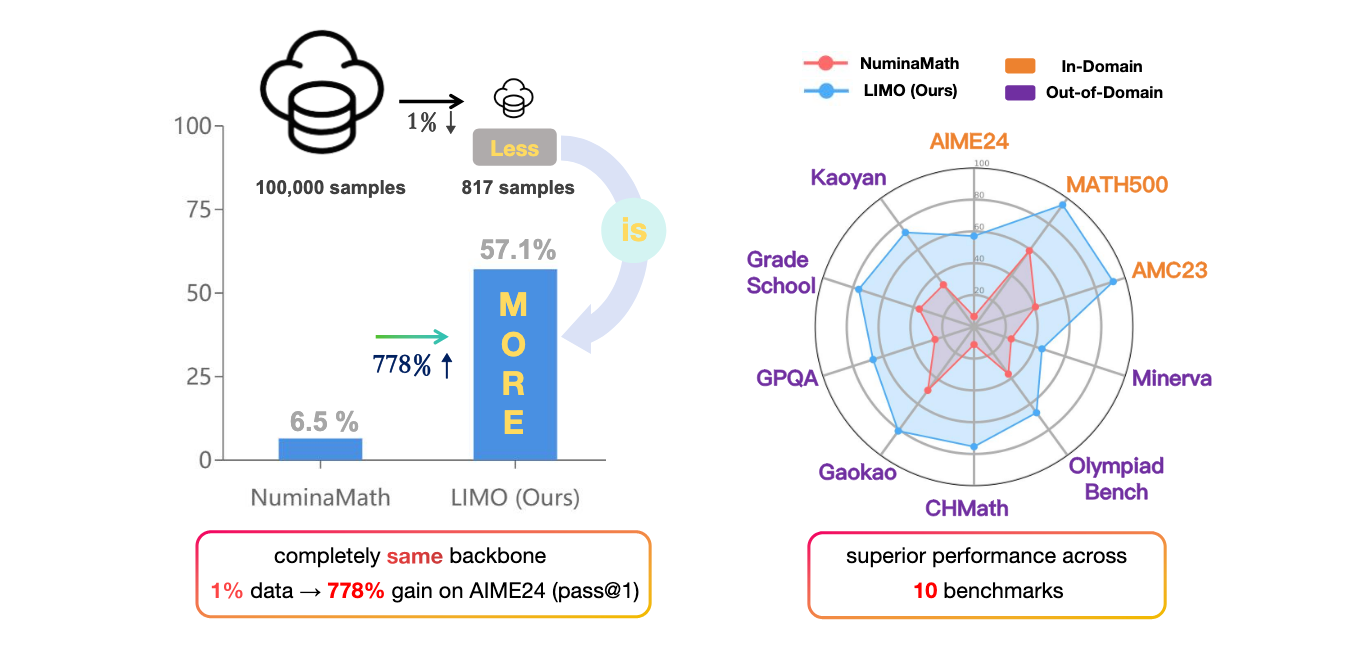
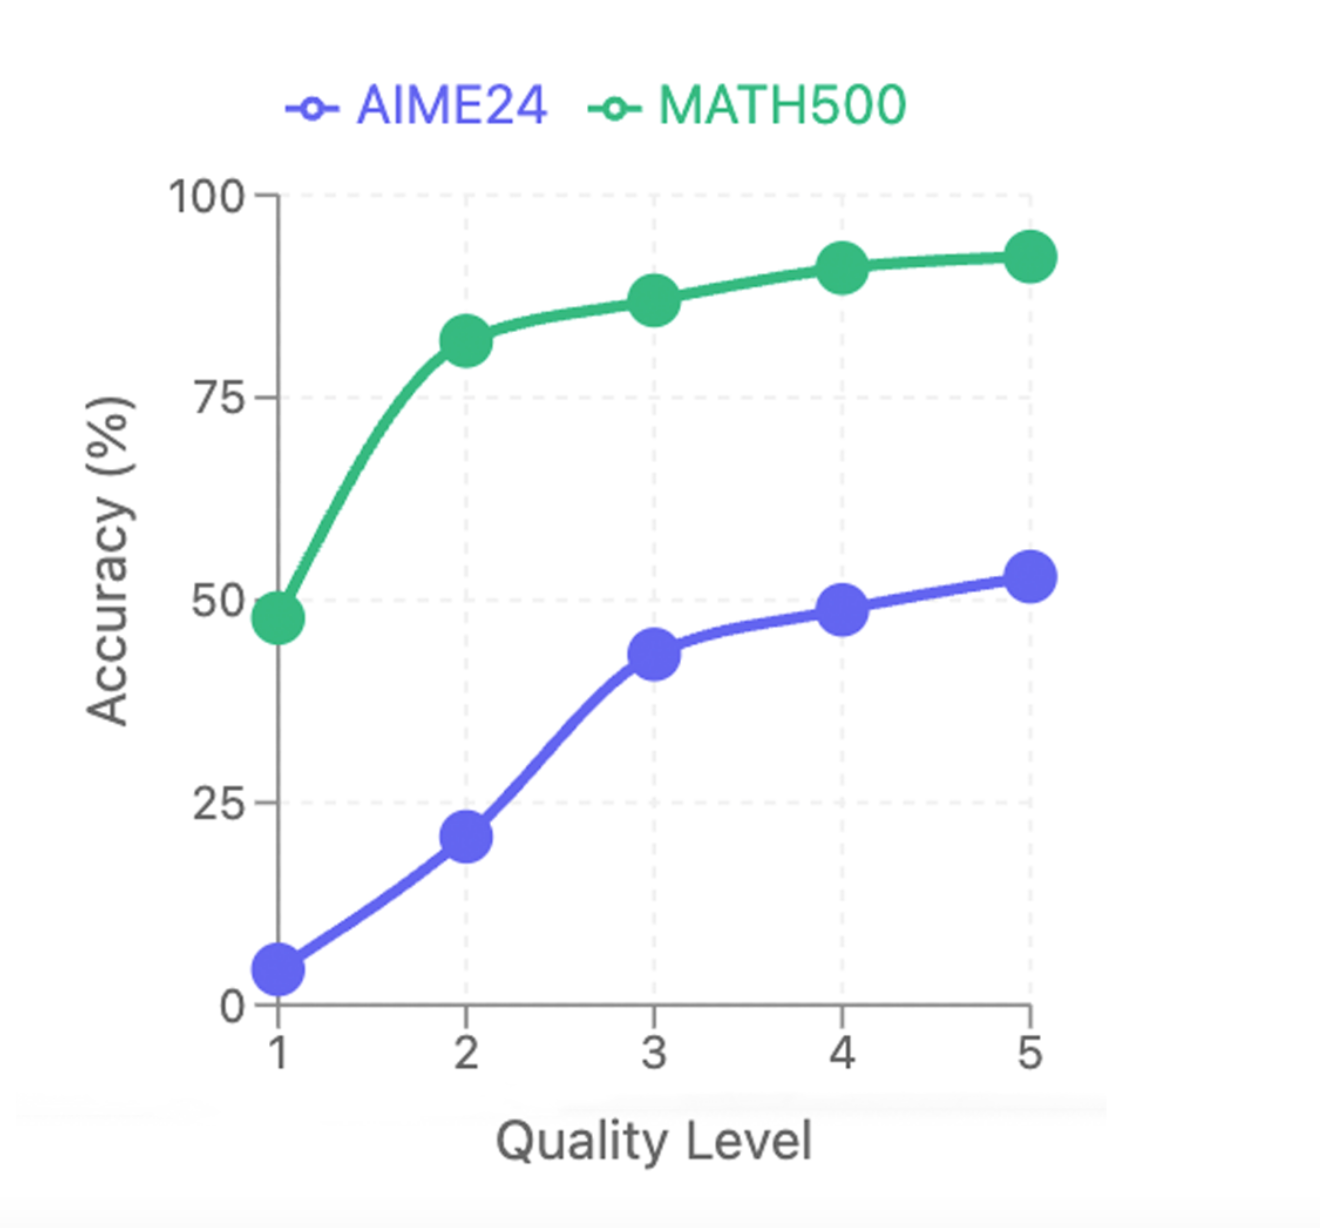
Os resultados experimentais revelam que o LIMO não apenas se destaca em tarefas no domínio, mas também demonstra uma generalização excepcional fora da distribuição, alcançando uma melhoria absoluta de 40,5% em 10 benchmarks diversos em comparação com modelos treinados em 100 vezes mais dados. Essa forte capacidade de generalização desafia diretamente a noção predominante de que o ajuste fino supervisionado leva inerentemente à memorização, em vez de ao raciocínio genuíno. Os autores conduziram análises comparativas rigorosas para entender quais fatores contribuem para o sucesso do LIMO, descobrindo que a qualidade da cadeia de raciocínio e a dificuldade do problema afetam significativamente o desempenho. A Figura 2 demonstra claramente a importância crucial da qualidade da cadeia de raciocínio, mostrando uma correlação direta entre o nível de qualidade dos exemplos de treinamento e o desempenho do modelo no AIME24 e no MATH500. As cadeias de raciocínio de alta qualidade são caracterizadas por uma organização estrutural clara, uma estrutura cognitiva eficaz e etapas de verificação frequentes, fornecendo evidências empíricas de por que o LIMO supera os modelos treinados em conjuntos de dados muito maiores.
Esse trabalho pioneiro tem profundas implicações para a pesquisa e o desenvolvimento de inteligência artificial. Isso sugere que mesmo habilidades de raciocínio complexas em nível de competição podem ser efetivamente obtidas por meio de exemplos mínimos, mas de alta qualidade, com conhecimento de domínio suficiente e espaço computacional para raciocinar. A hipótese LIMO identifica dois fatores críticos que determinam o limite de elicitação para raciocínio complexo: a integridade da base de conhecimento codificado do modelo durante o pré-treinamento e a eficácia dos exemplos pós-treinamento na demonstração de processos sistemáticos de resolução de problemas. Isso representa não apenas um argumento para a eficiência de dados, mas uma visão fundamental de como os recursos complexos de raciocínio emergem em grandes modelos de linguagem. Para facilitar a reprodutibilidade e futuras pesquisas em raciocínio eficiente em dados, os autores lançaram o LIMO como um pacote abrangente de código aberto, fornecendo recursos valiosos para a comunidade de IA desenvolver essa direção promissora.
Observações finais
A abordagem LIMO ressalta que métodos orientados por dados continuam sendo cruciais para liberar todo o potencial dos grandes modelos de linguagem. No entanto, isso afasta a conversa de simplesmente aumentando o volume de dados para melhorando sua qualidade. A pesquisa acadêmica, portanto, deve priorizar o design e o refinamento “modelos cognitivos” passo a passo de alta qualidade—da mesma forma que um professor explica cuidadosamente cada etapa de um problema para uma criança. Historicamente, a suposição era que mais dados inevitavelmente levam a um melhor desempenho em LLMs. O LIMO desafia isso sugerindo que pode haver um “ponto perfeito” ou limite de dados ideal—além dos quais exemplos adicionais podem introduzir ruído, redundância e retornos reduzidos.
Consequentemente, o futuro provavelmente envolve um humano no circuito processo, em que especialistas do domínio criam meticulosamente esses andaimes cognitivos. Ao fazer isso, eles guiarão os sistemas de IA com mais eficiência, levando a descobertas mais rápidas tanto na pesquisa quanto na solução de problemas do mundo real. Também poderia haver pesquisas sobre algoritmos agentes que poderiam criar essas etapas ideais, mas introduzir diversidade nessas etapas seria uma tarefa crucial.
Ao enfatizar qualidade terminado quantidade, LIMO abre caminho para mais sustentável, interpretável e eficiente Sistemas de IA. Trabalhos futuros provavelmente explorarão como automatizar esse processo, integre-o com experiência de domínio em aplicativos do mundo real e aborde de forma mais ampla ético e societário impactos. A combinação de artesanato humano na criação de “modelos cognitivos” e IA adaptável aprender e refinar esses modelos pode ser a chave para desbloquear a próxima onda de inovações revolucionárias em grandes modelos de linguagem.
Referências
[1] Ye, Y., Huang, Z., Xiao, Y., Chern, E., Xia, S. e Liu, P., 2025. LIMO: Menos é mais para raciocinar. Pré-impressão arXiv arXiv: 2502.03387. Disponível em: https://arxiv.org/pdf/2502.03387


Explore our content
Get to know and learn more about Cloudwalk below.