September 22, 2025
RAG, Tool-Calling e a luta contra as alucinações
Este artigo serve como uma pesquisa e uma perspectiva futurista sobre IA confiável, ancorada na recuperação de conhecimento.
Grandes modelos de linguagem (LLMs), treinados em grandes corpora de texto, codificam inerentemente uma quantidade surpreendente de conhecimento factual em uma geometria complexa. Com instruções cuidadosamente elaboradas, eles podem relembrar informações sobre história, ciência, cultura e muito mais. No entanto, ao contrário de um banco de dados estruturado, esse conhecimento é difusamente incorporado e distribuído em bilhões de parâmetros por treinamento sujeito a perdas por compressão (Bricken et al., 2023; Chlon et al., 2025), tornando a recuperação de fatos probabilística e vulnerável a alucinações. Este artigo serve como uma pesquisa e uma perspectiva futurista sobre IA confiável, ancorada na recuperação de conhecimento.
Para enfrentar esses desafios, várias direções foram exploradas: sondar modelos pré-treinados para conteúdo factual, aprimorá-los com geração aumentada de recuperação (RAG) ou integração de ferramentas e comparar a consistência factual. Abordagens complementares, como ajuste fino e novas medidas de incerteza (por exemplo, entropia semântica), buscam melhorar a confiabilidade e adaptar modelos a domínios específicos. Em termos de inovações de treinamento, estratégias estimulantes como Cadeia de Pensamento e Árvore de Pensamento foram aplicadas para aprimorar o raciocínio e a lembrança factual. Enquanto isso, os esforços para reduzir a alucinação no nível de treinamento incluem refinamentos arquitetônicos e novos objetivos, como funções aprimoradas do softmax e perdas de treinamento com reconhecimento de fatos. Ao mesmo tempo, os críticos — principalmente Yann Lecun — argumentam que os LLMs autorregressivos são estruturalmente restritos, gerando um debate sobre se as arquiteturas atuais podem realmente se transformar em sistemas de raciocínio confiáveis.
Geração aumentada por recuperação (RAG)
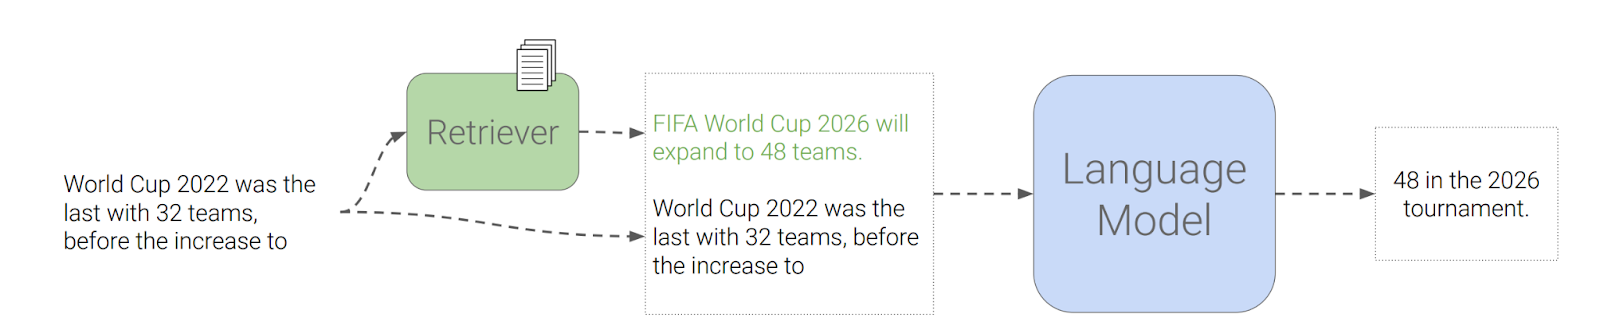
Em 2020, Lewis et al. introduziram a Geração Aumentada de Recuperação (RAG) com base em Memória paramétrica: o grande modelo de linguagem pré-treinada (LM), que codifica o conhecimento geral do mundo em seus pesos. Memória não paramétrica: um sistema de recuperação externo (por exemplo, um índice vetorial denso de passagens da Wikipedia). Recuperar: Em uma consulta (como uma solicitação do usuário), o recuperador encontra passagens relevantes de um grande corpus. Em termos mais técnicos, isso significa calcular a semelhança entre o conteúdo e a consulta; Aumentar: Essas passagens recuperadas são inseridas no gerador junto com a consulta; Gerar: O LM então produz uma resposta condicionada tanto à consulta quanto à evidência recuperada.
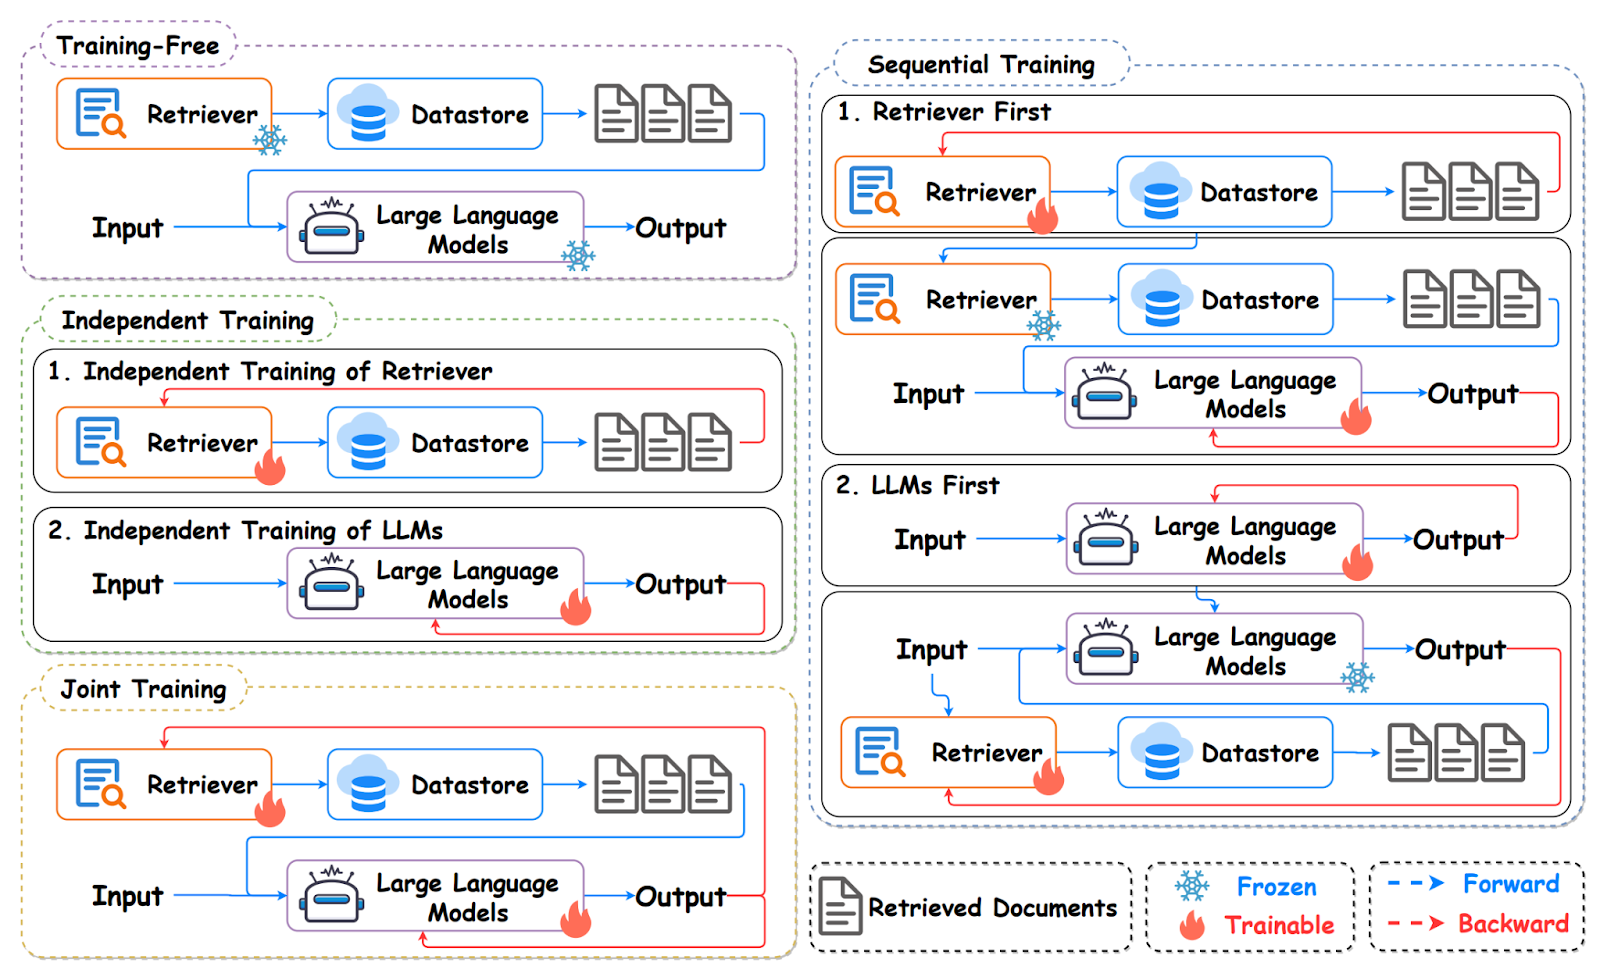
Na era LLM, o RAG: Generator é um enorme modelo básico (GPT-3, LLama, Mistral, etc.) com bilhões de parâmetros. Isso torna o gerador muito mais capaz, mas também mais propenso a alucinações se não estiver aterrado. O LLM RAG geralmente é um aumento não paramétrico sem ajuste fino (Ram et al., 2023; Ma et al., 2023): O LLM está congelado (API ou pesos abertos); Somente incorporações são treinadas/ajustadas (às vezes nem mesmo isso — transformadores de frases prontos para uso são usados). No entanto, os sistemas RAG tradicionais sempre recuperam um número fixo de documentos para geração, independentemente de a recuperação ser realmente necessária e também nunca reavaliam a qualidade da saída gerada.
Portanto, métodos mais avançados começaram a surgir — muitos para serem abordados em detalhes aqui. SELF-RAG (Asai et al., 2023) treina um LLM para (1) decidir quando para recuperar documentos externos, (2) gerar uma resposta e (3) crítico seu próprio trabalho — segmento por segmento — usando “tokens de reflexão” especiais. O Graph RAG (He et al., 2024; Edge et al., 2025) estrutura o corpus como um gráfico de conhecimento para que a recuperação possa ter como alvo entidades, relações e subgráficos multi-hop, permitindo a agregação do contexto local e global. O Agentic RAG (Chen et al., 2025) reformula o pipeline como um sistema multiagente cooperativo — por exemplo, planejador, recuperador, raciocinador, crítico — coordenado por meio de aprendizado por reforço multiagente em torno de uma recompensa compartilhada para produzir resultados mais alinhados e eficazes. Apesar do avanço de métodos mais recentes e poderosos, os custos envolvidos e a latência precisam ser levados em consideração, uma vez que algumas soluções são computacionalmente intensivas e podem consumir uma grande quantidade de tokens e outros recursos, até mesmo evoluindo o treinamento.
Chamada de ferramentas e RAG
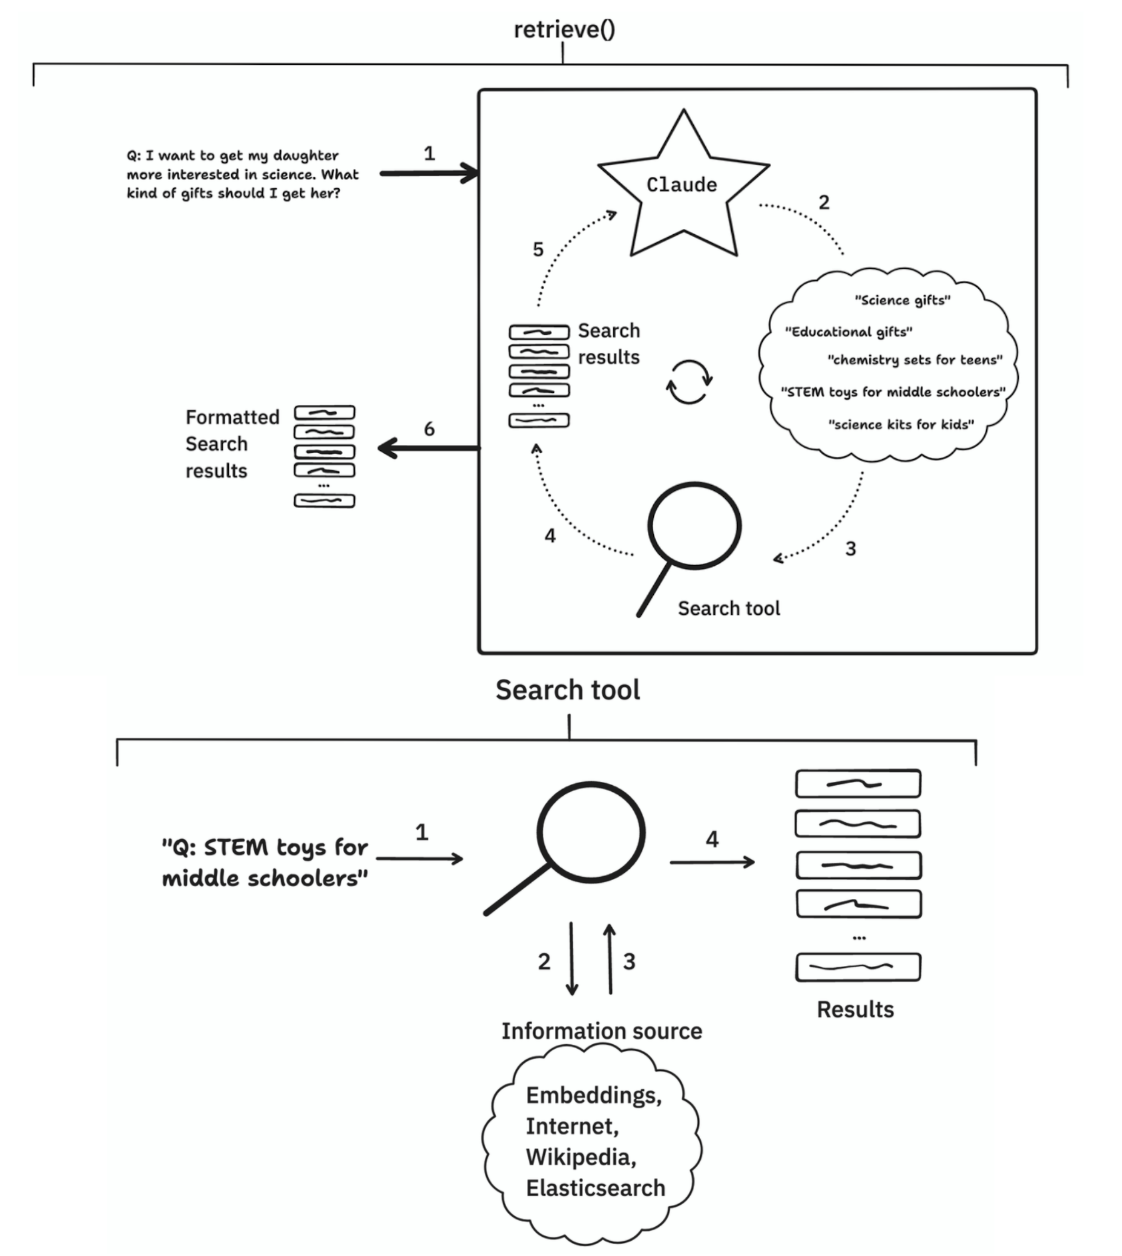
Uma alternativa ao RAG foi considerada a chamada de ferramentas, em que um LLM invoca APIs especializadas em vez de recuperar documentos. Por exemplo, em vez de pesquisar em uma base de conhecimento, o modelo pode chamar uma API meteorológica, uma função de consulta ao banco de dados ou uma calculadora, por exemplo, recuperação antrópica. A chamada de ferramentas enfatiza a precisão e a funcionalidade em vez da amplitude da recuperação. Enquanto o RAG aprimora a base factual com evidências de texto, a chamada de ferramentas capacita os LLMs a realizar ações no mundo real, integrar-se a dados estruturados e ampliar dinamicamente suas capacidades. No entanto, o ponto ideal está entre, na prática, muitos sistemas combinam RAG e chamada de ferramentas — recuperando documentos quando um contexto não estruturado é necessário e invocando APIs para fatos estruturados ou dinâmicos usando; estruturas de orquestração (LangChain, LlamaIndex, Haystack) controlam o ciclo de recuperação e geração.
Benchmarks de confiabilidade
Para medir a confiabilidade factual, existem vários benchmarks, como TruthfulQA, FactScore, SciQ, MMLU e HaLuEval. Eles visam avaliar se os modelos podem distinguir o fato da ficção, resistir a solicitações adversárias e fornecer respostas calibradas. Os benchmarks destacam pontos fracos no raciocínio factual dos LLMs, como afirmar falsidades com confiança ou falhar no conhecimento específico do domínio. No entanto, os próprios benchmarks podem ser limitantes, pois geralmente medem o desempenho estático em vez da robustez em contextos dinâmicos do mundo real e induzem um comportamento de adivinhação para aumentar o desempenho, o que será discutido mais adiante neste artigo (Fan et al., 2025).
Ajuste fino
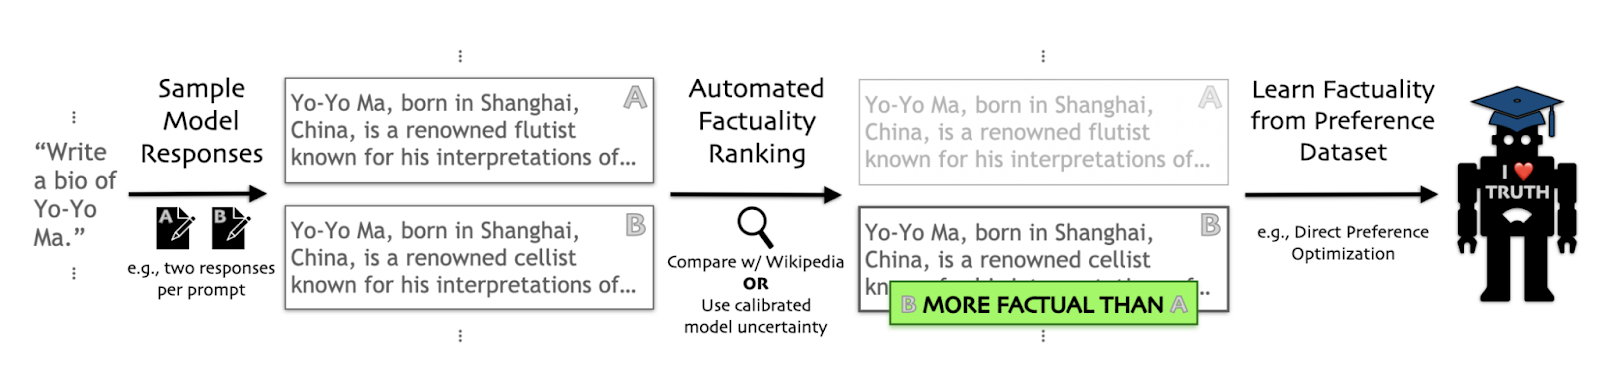
Os modelos pré-treinados geralmente são ajustados para garantir a confiabilidade; no entanto, já está claro que isso não é suficiente. Assim, etapas adicionais de ajuste fino podem ser incluídas para tornar os LLMs mais factuais, por exemplo, o método de Tian et al., 2024 aprendido a partir de classificações de preferências de factualidade geradas automaticamente — por meio de métodos baseados ou livres de recuperação — melhorando consideravelmente a precisão do Llama-2 em tópicos não vistos. Na escala 7B, essa abordagem reduz as taxas de erro factuais em 53% em biografias e 50% em perguntas e respostas médicas, superando as estratégias baseadas em RLHF e decodificação.
Além dos métodos já discutidos, os resultados geralmente também podem ser aprimorados com o ajuste fino do mecanismo de recuperação, por exemplo, incorporações. Isso normalmente começa com a construção de um conjunto de dados que define o que significa “semelhança” em seu contexto específico. Esses conjuntos de dados geralmente são organizados como trigêmeos: (âncora, positiva, negativa).
Âncora: A consulta ou frase original.
Positivo: Uma frase que é semanticamente muito parecida — ou até mesmo idêntica — à âncora.
Negativo: Uma frase relacionada ao tópico, mas semanticamente distinta.
Entropia como ferramenta de detecção
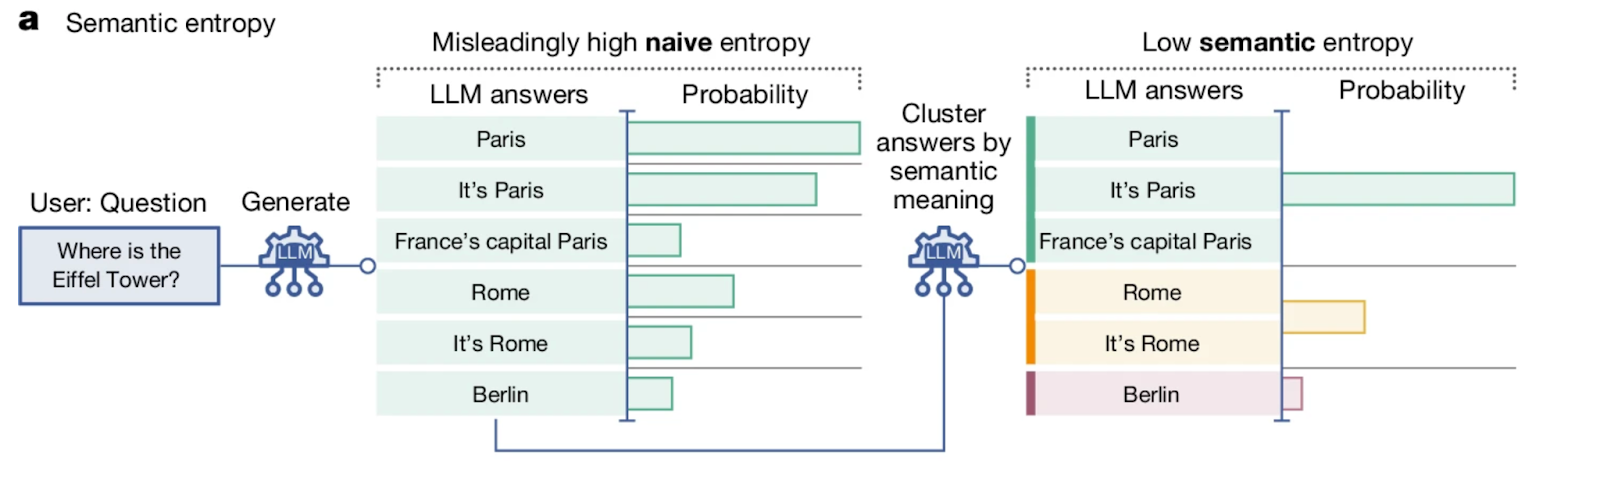
A entropia semântica é um método proposto para quantificar a incerteza nas saídas do LLM. Ao contrário da entropia clássica (que mede a incerteza na distribuição de probabilidade sobre os tokens), a entropia semântica avalia a incerteza no nível de significado agrupando várias saídas amostradas em grupos semanticamente distintos. Se surgirem muitos significados diversos, a entropia é alta; se os resultados convergem em uma única interpretação, a entropia é baixa. Isso é crucial para segurança e confiabilidade: um modelo pode gerar texto fluente com baixa entropia simbólica, mas ainda ter várias interpretações semânticas plausíveis, mas conflitantes. A medição da entropia semântica, que difere da entropia ingênua, oferece uma melhor visão de quando os modelos provavelmente não são confiáveis (Farquhar et al., 2025).
Mas por que os LLMs alucinam?
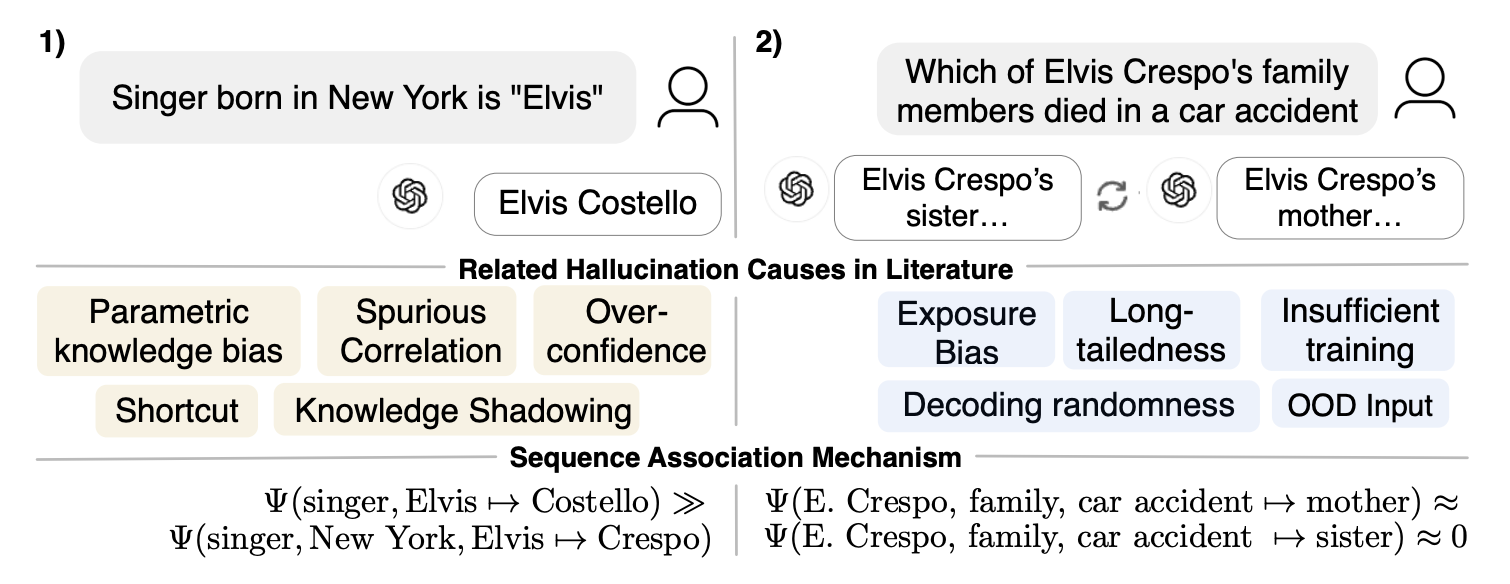
Conforme resumido por Sun et al., 2025, as alucinações geralmente surgem quando os modelos se apoiam em fatos memorizados (viés de conhecimento paramétrico) e em correlações espúrias, usam atalhos e expressam excesso de confiança; fatos populares ofuscam os raros (sombreamento do conhecimento) e entidades de cauda longa e baixa frequência sofrem. Durante a geração, o viés de exposição permite que os erros iniciais se agravem (Udandarao et al., 2024) e a aleatoriedade da decodificação pode empurrar as saídas para um caminho errado. Lacunas ou dispersão nos dados de treinamento e solicitações fora de distribuição impulsionam ainda mais o modelo a escolher a associação mais forte em vez da resposta correta.
No artigo da OpenAI, Fan et al. (2025) vão mais fundo e argumentam que as “alucinações” do LLM são esperadas pelos produtos do pré-treinamento: os erros generativos refletem as classificações errôneas supervisionadas da minimização da entropia cruzada. Eles também afirmam que as avaliações convencionais incentivam a alucinação; pequenos ajustes que, em vez disso, recompensam a incerteza calibrada podem realinhar os incentivos e facilitar a supressão da alucinação. Assim, os LLMs estão sendo otimizados para se saírem bem nos testes; portanto, quando não têm certeza, adivinhar geralmente os ajuda a obter uma pontuação melhor. Muitos benchmarks refletem exames padronizados e usam pontuações binárias, como precisão ou taxa de aprovação. Otimizá-los pode, inadvertidamente, estimular alucinações. Dessa forma, eles propõem uma mudança na forma como otimizamos os modelos para uma configuração que recompensa de forma diferente com outros benchmarks.
Opinião impopular de Yann LeCun sobre LLMs autorregressivos
Yann LeCun, vencedor do Prêmio Turing e cientista-chefe de IA da Meta, tem sido um crítico franco dos LLMs autorregressivos. Sua “opinião impopular” é que a previsão da próxima palavra é um caminho inadequado para a inteligência real e que os modelos autorregressivos estão finalmente condenados. De acordo com LeCun, esses modelos não podem ser tornados factuais, seguros ou controláveis de forma confiável. Ele enquadra o problema probabilisticamente: com uma taxa de erro e—a probabilidade de que qualquer token gerado fique fora do conjunto de respostas corretas—a probabilidade de que uma resposta inteira seja longa n permanece correto é dado por
P (correto) = (1 — e) ⇛
Essa probabilidade diverge exponencialmente à medida que as sequências ficam mais longas, tornando o problema fundamentalmente insolucionável em sua opinião. Em vez disso, a LeCun defende arquiteturas alternativas baseadas em modelos mundiais, representações estruturadas e aprendizado preditivo autosupervisionado além do texto. Embora grandes modelos de linguagem tenham mostrado uma versatilidade notável, apesar dessas falhas, sua crítica ressalta um debate contínuo: o dimensionamento de sistemas autorregressivos acabará atingindo um teto antes de atingir o raciocínio em nível humano? Mas é importante observar que, apesar de atraente, não há pesquisas suficientes nessa direção e muitos aspectos podem ser questionados. Por exemplo, a capacidade de atenção é um problema que tem sido enfrentado com notável sucesso em um ritmo acelerado.
Observações finais
Para concluir essa visão geral da IA confiável, oferecerei uma aposta futurista baseada em nossa discussão. Os LLMs estão sendo implantados em uma ampla variedade de aplicativos, o que, por sua vez, acelera seu progresso. No entanto, na busca por uma inteligência mais geral, os sistemas baseados em transformadores ainda se deparam com certas tarefas cognitivas, muitas das quais são triviais para humanos, mas surpreendentemente difíceis para LLMs (por exemplo, o viés do primeiro símbolo; confira nossa postagem no CloudWalk sobre esse tópico). Alguns problemas podem não ser solucionados apenas com modelos de linguagem. Do ponto de vista humano, a linguagem é baseada em modelos mundiais: é uma função distribuída do cérebro, fortemente acoplada aos sistemas sensório-motores e aos processos cognitivos de ordem superior. Minha aposta, portanto, é em abordagens de modelo mundial inspiradas no cérebro e na mente, novas arquiteturas que fundamentam e integram o conhecimento, para traçar o caminho em direção a sistemas verdadeiramente inteligentes. Isso não significa que os LLMs não permanecerão valiosos; eles já se destacam em muitos domínios, especialmente quando combinados em sistemas modulares que lidam com tarefas específicas. Mas é improvável que os LLMs por si só levem à inteligência geral.
Referências
Antrópico. (n.d.). demonstração de recuperação antrópica [Repositório do GitHub]. GitHub. Recuperado em 8 de setembro de 2025, de https://github.com/anthropics/anthropic-retrieval-demo
Bricken, T., Templeton, A., Batson, J., Chen, B., Jermyn, A., Conerly, T., Turner, N. L., Anil, C., Denison, C., Askell, A., Lasenby, R., Wu, Y., Kravec, S., Schiefer, N., Maxwell, T., Joseph, N., Tamkin, A. Guyen, K., McLean, B.,... Olah, C. (2023, 4 de outubro). Rumo à monosemanticidade: decompondo modelos de linguagem com o aprendizado de dicionário. Antrópico. https://transformer-circuits.pub/2023/monosemantic-features/
Chen, Y., Yan, L., Sun, W., Ma, X., Zhang, Y., Wang, S., Yin, D., Yang, Y. e Mao, J. (2025). Melhorando a geração aumentada por recuperação por meio do aprendizado por reforço multiagente. arXiv. https://doi.org/10.48550/arXiv.2501.15228
Chlon, L., Karim, A. e Chlon, M. (2025, 14 de setembro). Falhas de compressão previsíveis: por que os modelos de linguagem realmente alucinam [Pré-impressão]. arXiv. https://doi.org/10.48550/arXiv.2509.11208
Edge, D., Trinh, H., Cheng, N., Bradley, J., Chao, A., Mody, A., Truitt, S., Metropolitansky, D., Ness, R. O. e Larson, J. (2024). Do local ao global: uma abordagem de RAG gráfico para sumarização focada em consultas. arXiv. https://doi.org/10.48550/arXiv.2404.16130
Fan, W., Ding, Y., Ning, L., Wang, S., Li, H., Yin, D., Chua, T.-S., e Li, Q. (2024). Uma pesquisa sobre RAG reunindo LLMs: Rumo a modelos de grandes linguagens com recuperação aumentada. arXiv. https://doi.org/10.48550/arXiv.2405.06211
Farquhar, S., Kossen, J., Kuhn, L., et al. (2024). Detecção de alucinações em grandes modelos de linguagem usando entropia semântica. Natureza, 630, 625—630. https://doi.org/10.1038/s41586-024-07421-0
Ele, X., Tian, Y., Sun, Y., Chawla, N. V., Laurent, T., LeCun, Y., Bresson, X. e Hooi, B. (2024). G-Retriever: geração de recuperação aumentada para compreensão de gráficos textuais e resposta a perguntas. arXiv. https://doi.org/10.48550/arXiv.2402.07630
Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S. e Kiela, D. (2020). Geração aumentada de recuperação para tarefas de PNL com uso intensivo de conhecimento. Em H. Larochelle, M. Ranzato, R. Hadsell, M. F. Balcan e H. Lin (Eds. ), Avanços nos sistemas de processamento de informações neurais (Vol. 33, pp. 9459—9474). Curran Associates, Inc. https://doi.org/10.48550/arXiv.2005.11401
Ma, X., Gong, Y., He, P., Zhao, H. e Duan, N. (2023). Reescrita de consultas para modelos de grandes linguagens com recuperação aumentada. Em Anais da Conferência de 2023 sobre métodos empíricos em processamento de linguagem natural (EMNLP 2023). https://doi.org/10.48550/arXiv.2305.14283
Ram, O., Levine, Y., Dalmedigos, I., Muhlgays, D., Shashua, A., Leyton-Brown, K. e Shoham, Y. (2023). Modelos de linguagem com recuperação aumentada em contexto. Transações da Associação de Linguística Computacional. https://doi.org/10.48550/arXiv.2302.00083
Udandarao, V., Prabhu, A., Ghosh, A., Sharma, Y., Torr, P., Bibi, A., Albânia, S. e Bethge, M. (2024). Sem “tiro zero” sem dados exponenciais: a frequência do conceito de pré-treinamento determina o desempenho do modelo multimodal. Em Anais da Trigésima Oitava Conferência Anual sobre Sistemas de Processamento de Informações Neurais (NeuRIPS 2024). https://openreview.net/forum?id=9VbGjXLzig


Explore our content
Get to know and learn more about Cloudwalk below.